中國網/中國發展門戶網訊 數智驅動是當今世界科技呈現的新態勢和新特征。以ChatGPT模型為代表的GPT技術的出現,對學術、教育及產業界均帶來了變革。基礎科研領域的發展是大國科技競爭力的重要保證,直接決定了社會各方面進步的步伐,重要性不言而喻。目前,在基礎科學研究領域,基于GPT技術的研究已產生較多突破性成果,大語言模型技術在輔助科研人員進行研發工作或理解基礎科學問題的同時,也在改變甚至顛覆基礎科研生態。因此,對于我國而言,合理地促進GPT技術在包養科研中應用,不僅意味著科研效率的提升,更意味著科研“彎道超車”機遇的到來。
然而,也有另一部分學者在表達擔憂和焦慮,認為GPT技術雖然可以在多個基礎研究領域極大地提升科研效率,但它需要被合理使用,而不能被濫用;更有學者認為未來GPT技術甚至可以接管整個學術研究領域。那么,GPT技術在基礎科學研究領域的應用現狀如何?影響幾何?在研究中使用的邊界和隱患在哪里?針對這些問題,目前學界尚未給出一個系統性的分析框架和相關討論。為此,本研究立足以上問題,構建系統分析框架,討包養論GPT技術對于基礎科學研究的潛在影響和可能的應對方法,助力包養網科學研究生態的健康發展。
GPT技術變革及在科研中的應用
ChatGPT在自然語言處理方面表現出來的性能已然達到了一騎絕塵的地步包養,要想進一步理解ChatGPT具備如此優越性能的緣由,需要了解GPT家族模型的發展路徑(圖1)。
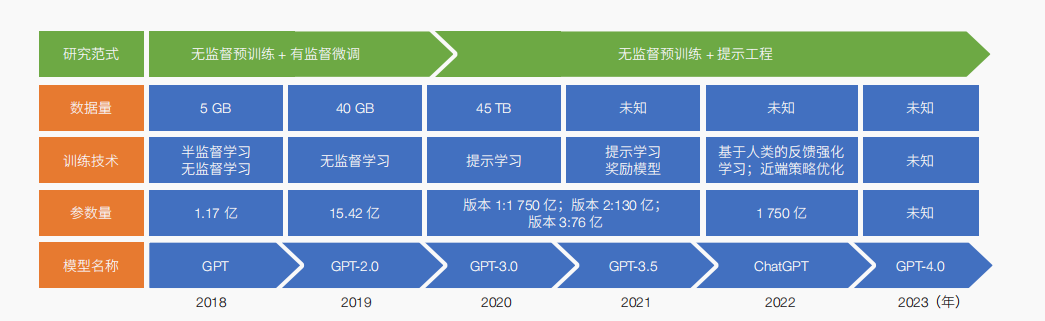
圖1 GPT技術的發展歷程
Figure 1 Development history of GPT technology
初代GPT模型采用無監督預訓練與有監督微調相結合的研究范式,著重訓練一個無監督預訓練語言模型,然后根據具體的任務有監督地微調模型。GPT-2.0模型的研究范式同上,改進點為通過大幅提升訓練數據量和模型規模在有監督任務中實現了更好的效果。GPT-3.0模型采用無監督預訓練與提示工程相結合的研究范式,即訓練過程中僅提供少量示例即可完成有監督任務。GPT-3.0模型共包含3個版本,分別對應著不同的參數量:1 750億、130億和76億。GPT-3.5為GPT-3.0的升級版,是一系列以GPT-3.0為基礎的改進模型(包括code-davinci-002模型等),通過評價模型的問答表現和獎懲措施進行優化更新而來。ChatGPT則是在GPT-3.5基礎上引入了基于人類反饋的強化學習(RLHF)和近端策略優化算法(PPO)進行微調,利用包養網偏好作為獎勵信號來微調模型,由此生成的回復符合人類的偏好。最后,GPT-4.0是在GPT-3.5版本的基礎上將文字到多模態的連通變成了現實。總而言之,GPT系列模型的成功標志著人工智能(AI)從以專用小模型訓練為主的“手工作坊時代”邁入到以通用大模型預訓練為主的“工業化時代”,成為AI發展的分水嶺。
GPT技術革命對基礎科學研究的影響
大語言模型的卓越性能為基礎科學研究帶來了廣泛的應用前景,能夠在眾多科學研究場景中應用或研發了一系列領域大語言模型。文章將從應用牽引、原理驅動、創新主體遷移3個視角分析GPT技術變革對基礎科研的影響(圖2)。
應用牽引及其影響
包含GPT模型在內的大語言模型帶來了一系列的技術革命,同時也在牽引著基礎科學領域中科學難題的突破,成為加速科研進程,提高科研效率的助推器。
應用牽引的3個模式
按照由低到高的能力層次,可將GPT技術在基礎科學研究中的應用分為3個模式(圖3)。
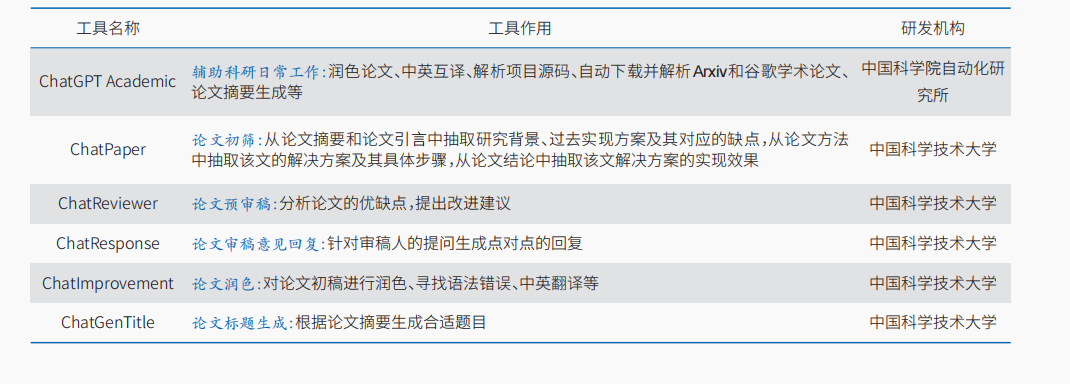
(1)工程化應用。該模式主要是增加GPT模型的對外接口,將其作為通用的科研數字助手,協助科學研究的日常工作流程,提升學術效率。以中國科學院研發的成果為例,GPT衍生模型的工程化應用案例如表1所示。
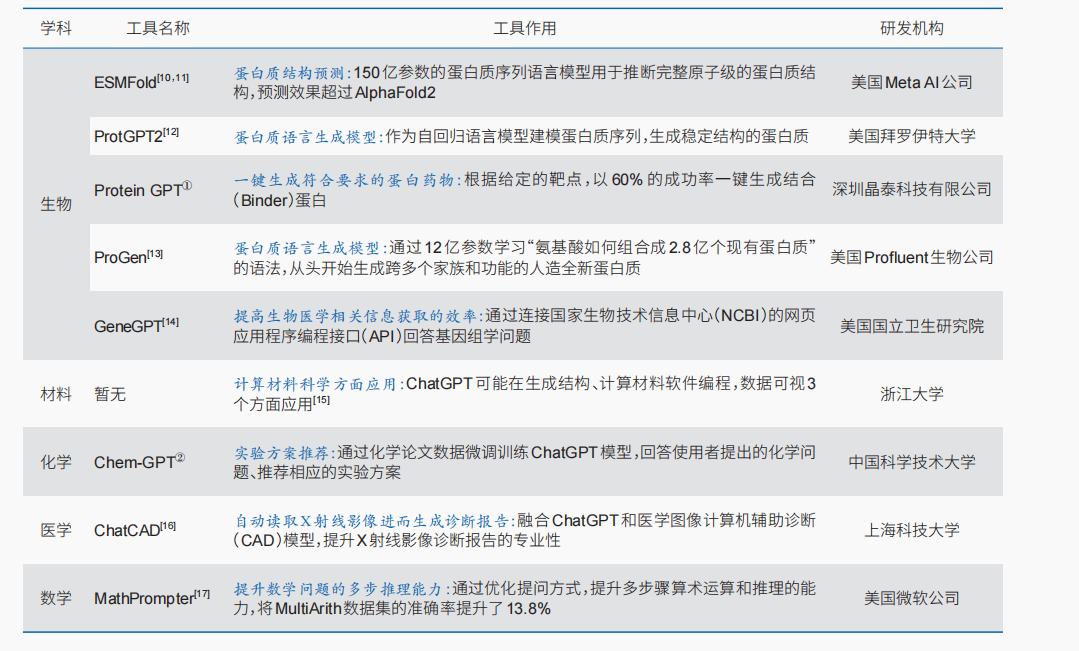
(2)學科科研創新的助力。該模式主要基于領域數據庫微調出GPT衍生模型(如基于蛋白質結構數據庫打造的Protein GPT),提高模型在特定科學研究任務上的性能和適配性。目前,ChatGPT的表現類似于通才,在細分的專業性上和行業中比較頂級的專家還有很大的差距。將ChatGPT作為通用AI的技術基座,通過在本地數據庫中進行微調,便可以提升模型在不同領域中的專業性,使其更適用于解決領域場景問題,成為科學假設空間的探索者,目前已有一些探索性研究工作(表2)。此外,AI推動基礎科學研究的前提還在于AI技術理解不同學科基礎知識,提升多元知識的表示和融合。這種情況下,首要的困難是專業領域科學家與AI專家的相互理解程度低,彼此互相促進的障礙仍然較高。
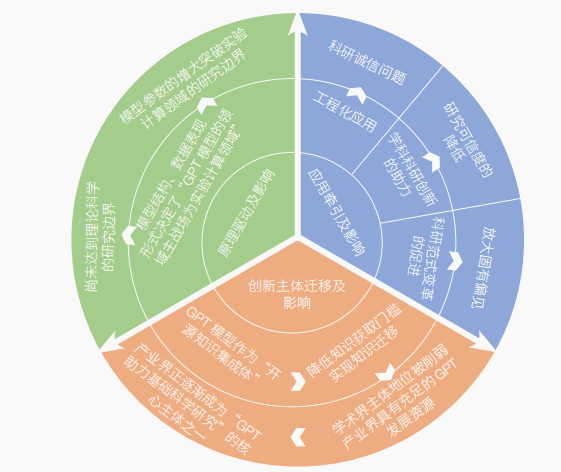
圖2 GPT技術變革對基礎科學研究影響的全景圖
Figure 2 Pa包養norama of impact of GPT technological change on fundamental scientific research
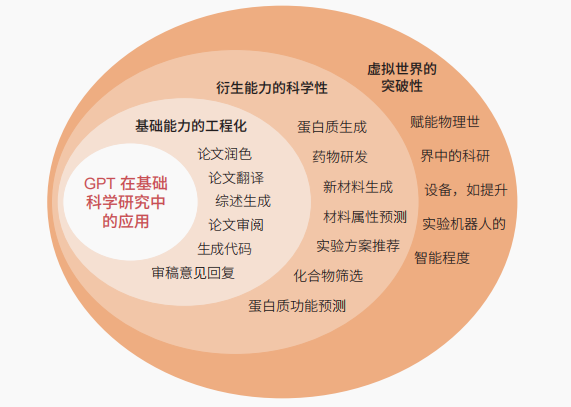
圖3 GPT助力科學研究應用現狀概念圖
Figure 3 Conceptual map of application status of GPT assists scientific research
科研范式變革的促進。目前,“人機共生”的科研場景中,根據機器的智能程度由低到高將機器分為輔助做實驗的“實驗員”,輔助高維空間計算的“AI科研助理”,自主進行科研全流程操作、突破人類科學家認知瓶頸的“AI科學家”,這3種形式各有側重,并行發展。GPT技術主要在后2種角色中發揮作用,即“科研范式變革促進”模式主要是希望突破“GPT類模型構建虛擬世界”的限制,通過加持實驗類的物理科研設備,以“AI科學家”的身份自主提出科研假說、自主設計實驗方案、自主驗證假說合理性(圖4)。
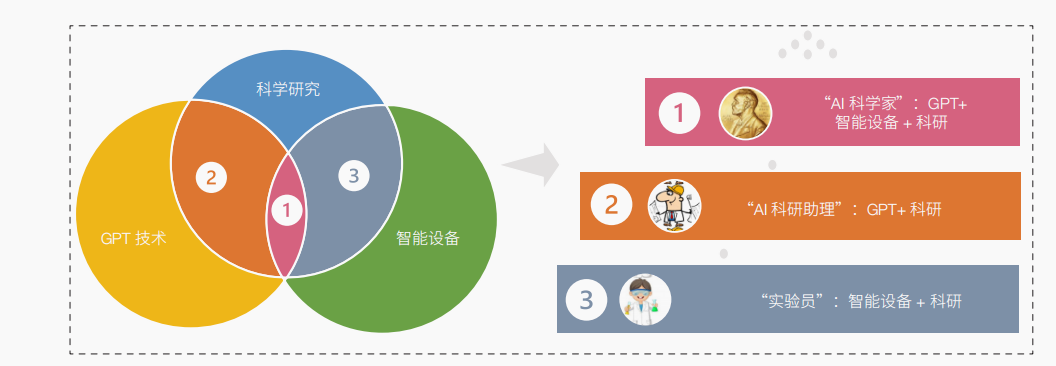
圖4 人機科研場景中的3種科研范式概念圖
Figure 4 Conceptual diagram of three paradigms in the human-machine scientific research scenes
表1 GPT衍生模型的工程化應用案例
Table 1 Engineering applications of GPT-derived models
目前,GPT技術與物理實驗設備的連接主要有2種方式:打通自然語言和機器指令之間的壁壘,自動生成機器人操作指令。已有研究借助GPT-4模型根據自然語言的實驗指令自動生成一種實驗機器人操作指令(OT-2),指揮機器人自動進行生物學實驗,極大節省了考慮機器操作細節編寫指令的時間;打通科研假設和科學實驗之間的壁壘,自主生成實驗方案。例如,中國科學技術大學研發的GPT衍生模型Chem-GPT,通過借助GPT模型“學習”50萬篇化學論文之后,自動給出其建議的化學實驗方案,同時驅動機器化學家“小來”做實驗,高效完成芬頓(Fenton)催化劑等化學品和新材料的研發問題。
應用模式的3個負影響
工程化應用模式中,不可避免地面臨科研誠信問題。從文本語法、格式的角度來看,ChatGPT是一個好的“論文制造者”。然而,所有的GPT框架產品都有一個共同特點,即制作者無法掌握程序內部發生的變化,也就是我們常說的“黑盒”。由于模型參數過大,GPT大模型會不可控地產生大量的虛構信息。此外,從科研倫理的角度來看,原創性是一篇論文的根本要求,用ChatGPT進行論文寫作,從形式上來說與抄襲無異。更讓人擔憂的是,隨著大語言模型的發展,編輯、出版商將很難分辨出AI代寫的文章。因此,如若對ChatGPT等AI技術進行誤用和濫用,將對科研誠信產生不可控包養網的沖擊。
表2 GPT衍生模型的科學性應用
Table 2 Scientific applications of GPT-derived models
科研創新模式中,模型透明度的降低削弱了研究可信度。目前,從GPT-4發布的技術報告來看,美國人工智能研究公司OpenAI出于競爭與安全等方面的考慮,未公布模型規模等技術細節,且之后最前沿的研究也趨向于不再發布相關論文開源技術的細節。對研究者來說,模型技術細節缺乏透明度,不僅是與開放科學的趨勢背道而馳,也會違背科學研究求證的科研態度。因此,如果繼續使用GPT開源模型或官方提供的應用程序編程接口(API)學習領域數據,則會威脅到結果可復現性,從根本上包養網削弱研究的可信度;同時,無法從根本上回答重大科學研究問題的機理機制,進而無法有根本性突破。
科研范式變革模式中,基于開源大數據訓練的GPT技術會潛在地放大固有偏見。由于ChatGPT的訓練數據來源于大量的互聯網數據,其中不可避免地記錄了人類社會潛在的歧視與價值對抗。當ChatGPT輸出明顯具有偏見的研究內容時,不僅影響研究者的判斷,更可能因為大量文本的廣泛傳播應用,加深研究者們的認知偏見。此外,在馬斯克聯名幾千位計算機科學家的請愿公開信中,羅列了8個AI危險推測和失敗模式,包括人類衰弱、認知侵蝕、欺騙等。
原理驅動及影響
基于GPT模型的科學研究已取得較多突破性成果。例如ProGen模型與ESMFold模型等蛋白質語言模型在蛋白質結構預測任務中表現突出,成為GPT模型在科學研究發展史中一座座里程碑。分析以上發展現狀背后的原理、特點及其未來的發展,對于科研人員厘清定位和科研邊界具有十分重要的啟發意義。包養
大量模型參數驅動實驗計算問題的高維空間擬合
GPT類大模型核心還是Transformer的體系結構,之所以能在基礎科學研究領域表現卓越,本質還是通過學習巨量的領域科學數據,借助大量模型參數對實驗計算問題的高維空間進行了有效擬合。換言之,輸出包養網的僅是統計學上的可能性,缺乏強包養有力理論知識的支撐。
應用的主戰場為數據計算密集型領域的高維復雜科學問題。分析上述案例可以發現,GPT技術在基礎科學研究中應用的主戰場為基礎科學研究中的實驗計算領域,即在分子生物學等數據積累豐富、結構化程度高、問題定義清晰的實驗計算領域。這主要是因為GPT技術在基礎科包養學研究中應用的本質是GPT技術的高維建模能力和科學第一性原理的結合。科學計算希望做的是從第一性原理及實驗觀測出發,將不同尺度現實世界發生的事情映射到計算模擬的世界中。然而,隨著問題復雜度的提升,以往經典的計算模式面臨“維度災難”的問題。AI技術則助力于解決科學計算中的維度災難問題,將不同尺度的物理模型有效連接起來,而物理模型的演繹能力又能產生更多數據,從而推動更好的AI解決方案。在此過程中,模型參數是衡量模型復雜度和能力的重要指標,也是基礎科學研究高維數據計算得以解決的重要因素。參數越多,意味著模型能夠處理更多的數據,學習更多的領域知識,更能幫助研究者探索高維數據的內在規律和關系,繼而能夠解決的科學研究問題的復雜度也越高。例如,在生物學領域,ProGen模型基于12億的模型參數學習蛋白質中氨基酸排序的規律,幫助研究者快速從頭構建全新的蛋白質。
模型適配性由數據表現形式決定包養。由于GPT模型的訓練、應用都是自然語言序列數據,因此,在實驗計算科學問題中,只有與自然語言相似的序列領域數據才可以用GPT模型進行編譯,進而學習蘊含其中的高維復雜知識。典型的領域序列數據有:領域論文、專利數據是天然的自然語言數據。例如,Chem-GPT基于開源的GPT代碼,“閱讀”近50萬的化學論文,可以基于學習到的論文知識自動回答研究者提出的化學問題,甚至可以給出某化合物合成的實驗方案,并高效完成化合物的研發。此外,還有基于4 000億字符訓練的生成式專利語言模型——PatentGPT-J-6B,用于自動生成專利權利要求書。生物大分子,尤其是蛋白質,可以看成是用遺傳密碼撰寫的語句,具有更為復雜的關聯知識。以“生物版ChatGPT”的ProGen模型為例,通過學習氨基酸如何組合成2.8億個現有蛋白質的“語法”,學習到了蛋白質中氨基酸排序的規律及其與蛋白結構和功能的關系,進而可從頭開始生成跨多個家族和功能的人造全新蛋白質。
原理驅動視角下的GPT模型應用邊界
(1)突破實驗計算領域的研究邊界。當模型參數超過臨界值,GPT模型將突破實驗計算領域中的研究問題邊界,表現出一定的“涌現性”。AI大模型領域的“涌現性”,通俗性表述是在小規模模型中不存在,但在模型參數超過閾值的大規模模型中存在的能力。這些能力在模型訓練時沒有被特別指定,而是由模型的多層結構和參數之間的相互協同作用自發產生的。根據Chung等學者的研究,模型參數規模在大于62億的情況下,可涌現出之前較小模型不具備的能力,模型能力會完成從量變到質變的飛躍,呈現出驚人的爆發式增長。此外,大模型的涌現能力還存在一些懸而未決的問題,如是什么控制包養網了哪些能力會涌現?如何控制模型涌現理想的能力并確保不理想的能力永不涌現?也有研究對大模型的“涌現力”提出質疑,認為只是人為選擇度量指標的結果,當評價指標換成更為連續、平滑的度量指標之后,涌現現象就不那么明顯了,但目前絕大多數研究支持大模型涌現性的存在。總之,由于涌現現象的難以預測性和不確定性,需要謹慎地處理涌現結果,并進一步驗證和分析其輸出結果。
尚未到達理論推導的研究邊界。雖然GPT類模型在實驗計算科學問題上表現得非常出色,甚至能夠通過圖靈測試,但它尚不能自主進行理論推導的科學研究任務。在“AI笛卡爾”模型的研究中,認為ChatGPT的大型語言模型邏輯能力有限,尚不能從公理化的知識和實驗數據中對自然現象模型進行原理性的推導。針對這個問題,主要從兩個角度分析① 理論推導的核心能力是需要理解因果,而GPT模型表現出來的“智能”僅僅是源于數據擬合。AI科學家朱迪亞•珀爾認為理解來源于因果模型,而非源于數據擬合。ChatGPT僅僅依賴于大量文本數據進行包養預訓練和微調,缺乏對真實世界的直接觀察和經驗,難以判斷事件的因果關系。它表現出來的“智能”僅僅是來自人類語料庫里已有的內容,當問題在語料庫中不存在人類創作的答案時,ChatGPT智能系統便是“無解”。然而,對于理論科學來說,最包養網重要的是推導出新的能夠解釋這個世界的理論公式。盡管AI大模型可以產生正確的“科學”預測(例如可以預測小球運動軌跡的AI Physicist模型),但這種經由訓練而來的AI系統,更像是一個死記硬背學習物理課本的學生,他知道每個問題的正確答案,前提是這個問題在書里出現過,但這并不是真正的科學創新!朱迪亞•珀爾的研究提示引進因果結構模型研究,通過2種研究進路的互補,形成功能—結構深度融合的智能系統或許是新的研究方向。 AI模型的黑箱工作機制導致GPT模型尚不具備理論的可解釋能力。哲學家卡爾•波普爾指出,科學家們尋求的不是高度可能的理論而是解釋,即強大而高度不可能的理論。然而,GPT模型仍然是一種基于神經網絡的黑箱模型,不能解釋其內部的工作機制,其表現出來的“智能”也并非類似于人腦結構和認知機制,更像是一個模包養式匹配統計引擎,輸出的僅是統計學上的可能性,這與現實情況下人類的思考模式是大不相同的。人腦只需要少量信息即可運作,因為它不尋求推斷數據點之間的直接相關性,而是尋求解釋。也就包養網是說,目前的GPT模型核心還是描述和預測,輸出結果總還是缺乏了強有力的支撐,不能像人腦一樣進行跨領域、跨模態的理論推導。
創新主體遷移及其影響
分析上述內容中的案例可以發現,產業界正逐漸成為GPT助力基礎科學研究的核心主體之一。究其原因是GPT模型在科學研究中的參與實現了知識遷移,同時降低了知識獲取門檻,由此削弱了學術界的主導地位;同時產業界憑借其充足的AI技術發展資源,使其成為GPT技術創新高地,進而有望成為基礎科學研究的核心創新主體之一。
作為開源知識集成庫,GPT模型助力知識遷移、降低知識獲取門檻
創新主體遷移的根本原因是大量數據訓練過的神經網絡變為一種新的數據、知識存儲模型,GPT類模型更是包養網成為一個擁有豐富知識與經驗的“專家”,一個開源知識集成庫,由此實現了不同語種間的知識遷移,同時降低了知識獲取的門檻。一方面,模型的訓練語料是全球各語種的知識庫,大多以問答的形式開源給模型的使用者,使全球任何語種的人都能使用大模型來學習不同語言的知識,實包養網現不同語言間的知識遷移;另一方面,由于GPT類模型成為一種新的數據、知識存儲模型,讓信息檢索方式從關鍵字檢索轉變成具備完整語義的自然語言人機交互檢索,以智能問答的方式改變了原有的知識查詢與獲取的方式,更甚者是對科研方式的顛覆。簡言之,GPT類大模型的存在將會降低科學研究壁壘,吸引更多的學生、產業參與到科學研究中來。
在大模型普及的時代,GPT大模型可以作為輔助教學和學習的工具,支持各水平等級的學生進行個性化、自適應學習,并協助其參與到基礎科學研究中。例如,有研究測試了GPT-4在物理教育評估工具“力學概念測試FCI”中的表現情況,發現GPT-4以28分(滿分30分)的成績展示了其在物理學教育中的潛力。然而,GPT雖然可以在通識與專業知識上提供極大幫助,但這代替不了創新性科研人才所必需的批判性思維、好奇心、想象力、經歷與經驗,這些特質恰恰是受過專業科研訓練的人所特有的優勢,也是人機協同科研場景中學者發揮優勢、尋找定位的立足點。
科學研究壁壘的降低,吸引了更多的企業和非學術機構參與到基礎科學研究中。例如,深圳晶泰科技通有限公司過訓練蛋白質類的Protein GPT模型,賦能實驗機器人的生物研發,使其研發重心逐漸從“實驗機器人”轉向具備一定生物領域知識的“實驗科學家”。
充足的GPT技術發展資源,助力產業界有望成為基礎科學研究的核心創新主體之一
GPT模型作為開源知識集成庫的存在,降低了知識獲取、科學研究的壁壘,一定程度上削弱了學術界在基礎科學研究中的主導和控制地位。而產業界憑借其充足的AI技術發展資源,即算力、數據、場景、人和資本等優勢的有機融合,使得人工智能驅動的科學研究(AI for Sci包養網ence)正在向產業界傾斜。
從產業界對于AI技術的人才、算力和資金等支配性資源投入上看,AI高科技企業資源已遠遠超過學術研究機構。2020年,約70%的AI領域博士進入產業界;2021年,產業界模型算力平均比學術界模型大29倍;2021年,全球產業界花費了超過3 400億美元用于AI,遠遠超過了公共政策投資。而這種關鍵性資源的投入正轉化為日益突出的AI研究成果中,如源于產業界的相關GPT模型成果有初創公司Profluent研發的ProGen模型。從GPT大模型擴展到整個AI研究領域,產業界還研發,甚至是掌控著AI模型開發工具(例如PyTorch和TensorFlow)、促進深度學習模型高效訓練的硬件(例如張量處理單元TPU)和可公開訪問的預訓練模型(例如Open Pretrained Transformer模型)。也就是說,在數據密集型和計算密集型的基礎科學領域,如蛋白質結包養構生成、化合物反應路徑生成、實驗方案自動生成、高分子材料遴選等領域,產業界對AI算法研究的支配也將賦予產業界塑造基礎研究方向的力量。
該現狀對于產業界和學界的學科研究定位也將產生相關影響。一方面,產業界商業動機的存在,促使他們將GPT等AI模型更多地應用到以利潤為導向的研究領域,如醫藥、材料等實驗計算領域中的科學問題場景中。即計算密集型領域科學問題的突破將慢慢由產業界和學術界共同突破得來,類似于“巴斯德象限”問題(巴氏殺菌的應用研究和基礎研究之間存在類似的重疊)。然而,這將潛在引導社會發展方向,并對低收入水平國家的學術研究形成壁壘。另一方面,對于一些根本性的基礎研究,如生命的起源、宇宙大爆包養炸、量子糾纏的形成機制等理論性研究問題,還需要高等院校與科研機構作為最主要的核心創新主體。
關于我國基于GPT技術發展基礎科學研究的建議
AI大模型通過重構人類知識檢索、運用的基本方式,成為一種新的生產力。然而,由于GPT大模型具有重投入、長周期、快迭代、高風險等特點,決定了GPT大模型在基礎科學研究中的競爭是大國游戲。在這場競賽中,中國正處于奮起直追的關鍵時期,亟待找到高質量發展的新路。基于上述現狀和影響,提出以下3方面建議。
投資研發國家自主可控、受知識產權保護的數據與計算平臺,為GPT技術推動基礎科學發展提供基礎設施建設。縱觀全球,有關促使“AI推動基礎科學研究”的政策調控陸續出現。從GPT的實現要素看,主要從數據、平臺方面加大資源投入。 建立高質量科學數據集勢在必行。大模型的“智商”取決于被訓練的數據量和知識密度。據了解,在GPT-3訓練時語料清洗前為45 TB,清洗后570 GB,這表示ChatGPT模型訓練時對數據清洗質量具有極致的要求。然而,我國目前高質量的、自主可控的科學數據庫較少。可行路徑之一為自動抽取已發表科技成果中的科學數據,結構化存儲在數據庫里,將其打造成AI for Science時代下重要的生產要素和戰略資產。將AI數據計算平臺打造成科研過程中的基礎設施,加大硬件和經費支持。建議打造數據計算通用平臺,嵌入科研過程。通用的包養意義在于使開發人員可以在此基礎上解決更多有針對性的問題,快速部署到任何學科領域。此外,各地分散式建設智算中心,將全國統一的AI算力市場和服務市場肢解為一個個孤立破碎的小市場,消解了我國大國大巿場的優勢。只有依靠大型科技公司或研發機構“煉大模型”,才能逐步彌補中美在模型層面的差距。對于開源的AI算法進行產業化時,還需要注意到知識產權的風險。例如,深度神經網絡算法的基礎架構(如Transformer、Attention)已被谷歌申請專利,基于這些模型架構設計的產品存在知識產權風險,或將阻礙我國數智科研的產業化。因此,構建我國自主可控的安全的替代技術尤為重要。
從產學包養網研模式、青年人才資源和知識跨領域流動3方面,為Al推動基礎科學發展營造可持續健康生態。大力提倡產學研模式,讓參與主體各顯本領,保證AI技術健康發展導向。高校、科研機構擁有培養研發人才的責任和包養網優勢,更關注科學原理;企業則擁有算力、資金和平臺建設能力,對解決工程問題具有獨特優勢,可以集中人力和財力進行攻關。將高校、科研機包養構開發的優勢與企業的產品化優勢有效結合,實現產學研各方的資源共享,優勢互補,將健康推動我國基礎科學的發展。引人育人,充分培養吸納海內外青年人才,保證人才資源的不竭供應。青年人才是AI技術及基礎科學發展最為寶貴的資源。ChatGPT團隊的平均年齡僅32歲,憑借對AI技術的興趣和信仰,便引爆全球新一輪AI技術浪潮。同時,該團隊中華人學者是一支重要的科技創新力量。因此,鼓勵國外頂尖學者走進來、國內學者走出去,激發、培養青年人的科技興趣和信仰,對促進國內前沿科技創新發展也具有重要意義。促進知識跨領域流動,推動AI技術與基礎科學發展有機結合。為保障AI技術賦能基礎科學研究的可持續性,我國可考慮出臺相關跨領域知識交流政策,鼓勵AI賦能下的基礎科學研究項目等措施。例如,2023年3月27日,科學技術部會同國家自然科學基金委啟動“人工智能驅動的科學研究”專項部署工作,鼓勵計算機、數據科學、材料、化學、生物等學科的交叉融合,重構知識體系。
鼓勵人機協作與科研誠信監管并重,為Al推動基礎科學發展營造公開透明的環境。當前,科學研究不可避免地正進入人機協作的時代,微軟公司更是認為GPT-4是通用AI的火花。隨著相關GPT技術產品包養在科研領域展開應用,相關工具是否會削弱研究人員的研究能力和地位成為主要問題之一。一方面,類似于Alpha Fold模型、RoseTTAFold模型這樣“把一個公認的具有重大意義的科學難題(蛋白質結構生成)突進到幾乎破解地步”的情況,展現了AI工具擁有通過圖靈測試、進而獲得諾貝爾獎的潛力;另一方面,我們還需要清醒地認識到當前的AI for Science模型,包括最新的GPT-4,存在著生成錯誤文本信息、邏輯推理和因果推斷的表現能力較低等問題,因此它們尚不能算是一個完美的科研工具。總的來說,GPT類大模型的應用價值將在文本處理等方面幫助學者處理初級科研任務,或在高維數據建模方面幫助學者處理科研計算任務,但其應用效果還取包養網決于學者的認知水平。此外,針對“ChatGPT自動撰寫論文”的問題,國內外知名期刊大多持反對態度。Science明確表示禁止將ChatGPT列為合著者,且不允許在論文中使用ChatGPT所生產的文本;Nature表示可以在論文中使用大型語言模型生成的文本,但不能將其列為論文合著者,只能在方法或致謝中表明。然而,以ChatGPT為代表的通用型AI介入科研生活已成定局,除了“堅持人工驗證”“制定問責規則”“投資真正開放的GPT模型”之外,還應加快構包養網建公開透明的“AI文本探測器”,自動識別AI生成的文本,從而使整個科研生態受益。。
(作者:孫蒙鴿、韓濤、王燕鵬、黃雨馨、劉細文,中國科學院文獻情報中心中國科學院大學經濟與管理學院;編審:金婷,《中國科學院院刊》供稿))
發佈留言